セキュリティ運用をゼロから見直すシリーズの第3回。
第2回では、エクサフォースが生ログを専用のセマンティックモデルに変換する仕組みを紹介しました。サブプリンシパルをラベル付けしたSaaSイベント、APIコントラクトを自動発見したアクセスログ、完全なプロセスチェーンを持つEDRテレメトリなどです。
しかし、セマンティックモデルは全体の半分にすぎません。モデルが構造化するのは何が起きたかです。それが重要かどうかを判断するには、その周囲にあるコンテキストを知る必要があります。その人物が誰で、何にアクセスできて、権限が実際の利用と釣り合っているか、デバイスはどのような状態か、そしてふるまいの履歴から見て何が「普通」なのか、です。
SIEMはログしか取り込まないため、このコンテキストを持っていません。エクサフォースは、接続されたすべてのシステムから設定の状態を取得してナレッジグラフを構築します。システムが生成するイベントだけでなく、イベントに意味を与えるポスチャ、権限、関係性までを取り込みます。
コンテキストの構築:ログだけでなく設定も
エクサフォースとSIEMの最大のアーキテクチャ上の違いは、ログの処理方法ではありません。ログで止まらないことです。
接続されたすべてのシステムについて、イベントストリームと並んで存在する設定とアイデンティティの状態を取得します。
IDプロバイダー(Okta、Azure AD、PingIdentity)から:ユーザーのロールと管理者ステータス。ユーザーごとのMFA登録状況と認証要素の強度。グループのメンバーシップ。アプリケーションの割り当て。セッションポリシー。パスワードポリシー。作成日とスコープを含むAPIトークンの一覧。
MDMプラットフォーム(Jamf、Kandji、Intune)から:デバイスとユーザーの割り当て。デバイスの種類、OSバージョン、コンプライアンス状態。インストール済みアプリケーション。ブラウザ拡張機能。暗号化の状態。EDRエージェントの稼働状況。
人事システム(BambooHR、Workday)から:部署、上司、役職、勤務地。在籍状況と入社日。該当する場合は退職日。
クラウドプロバイダー(AWS、GCP、Azure)から:IAMポリシーとロールの割り当て。リソースのタグ(PII、本番、公開)。バケットの権限。サービスアカウントの設定。アカウント間の信頼関係。
SaaSアプリケーション(GitHub、Google Workspace、Slack、Atlassian)から:組織の設定。リポジトリの権限と可視性。OAuthアプリの許可とトークンのスコープ。ファイル共有ポリシー。チャンネルのメンバーシップ。
イベントストリームそのものから:時間をかけて学習したふるまいのベースライン。各ユーザーがどのASNから、どの都市から、どのツールで、どのイベントタイプを、どの頻度で発生させているか。APIエンドポイントのリクエストレート、パラメータのスキーマ、レスポンスのパターン。
この設定の状態こそが、ナレッジグラフを満たすものです。
ナレッジグラフ:コンテキストが構造になる仕組み
設定とベースラインはそれ単体でも有用です。しかし本当の力は、それらの間の関係性から生まれます。ナレッジグラフが捉えるのはその関係性です。
ナレッジグラフは、企業のセキュリティに関わる状態をつなぎ合わせて表現したものです。ユーザーのフラットなデータベース、別に用意されたデバイスのデータベース、さらに別のクラウドリソースのデータベース、というものではありません。関係性のグラフです。
- JaneはFinance部門に所属し、その部門は本番AWSアカウントにアクセスでき、そのアカウントにはPIIタグ付きのS3バケットがある
- JaneはOkta(管理者)、GitHub(メンバー)、Slack(メンバー)、AWS(IAMロールJaneDev)にプロビジョニングされている
- JaneはMacBook-serial-XYZを所有し(MDMより)、そこではCrowdStrikeが稼働している(エージェントは正常、最終チェックインは2時間前)
- JaneはBackup Tool(read/writeスコープ、最終利用は3日前)とCI/CD Tool(repoスコープ、最終利用は昨日)にOAuthの許可を与えている
- JaneはBobの部下であり、BobはFinanceでほかに5人を管理している
こうした関係性があるからこそ、ログ検索では決して答えられない問いに、システムが答えられるのです。
- 「Janeのアカウントが侵害されたら、攻撃者はどこまで到達できるか?」
- 「このデバイスはJaneに割り当てられたノートPCか、それとも未知のマシンか?」
- 「Janeの実際の権限利用は、管理者ロールを正当化するものか?」
- 「Janeの部門のほかの誰かが、このASNからログインしたことはあるか?」
グラフには2つの層があります。コンテキスト層は設定から構築されます。アイデンティティのポスチャ、デバイスの状態、リソースの機密度、権限、組織構造です。ゆっくりと変化し、設定が再取得されるたびに更新されます。
1つのアイデンティティのナレッジグラフ。グループ、ロール、アプリケーション、そしてそこから到達できるリソースが、ひとつながりの構造として表示されています。
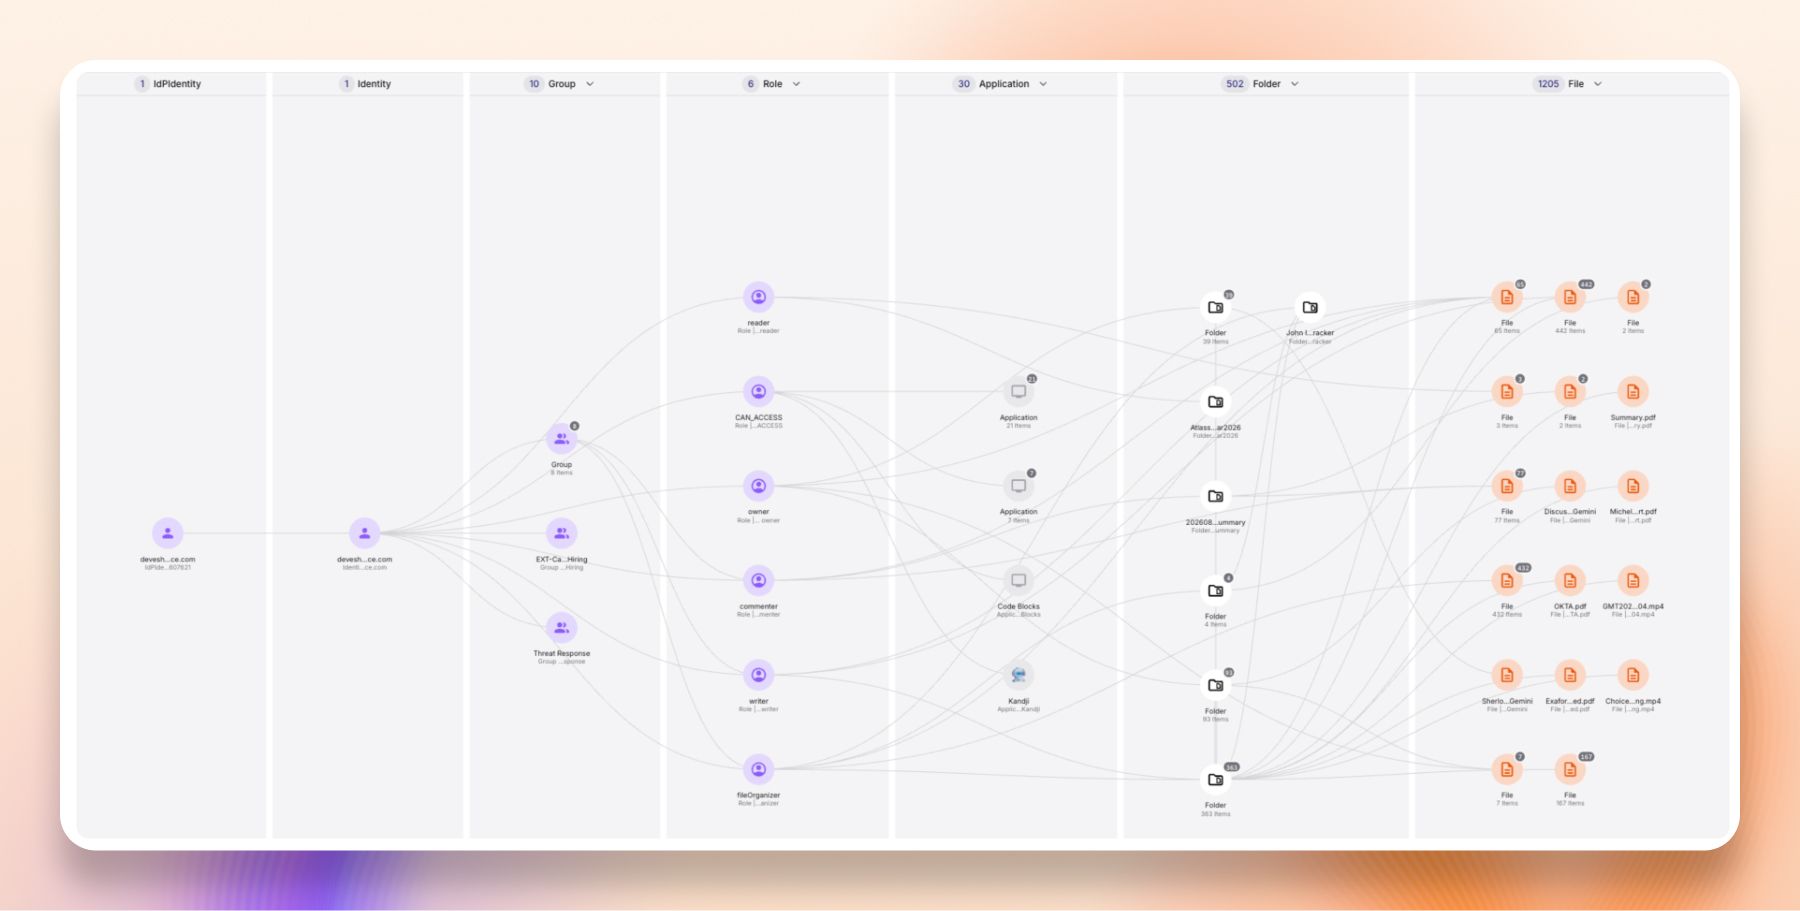
アクティビティ層は、第2回で説明したセマンティックモデルから構築されます。人とアプリケーションが実際に何をしているかを記述するイベントです。ふるまいのベースラインはその交点にあります。アクティビティ層から計算されますが、検出の際にはコンテキスト層と並べて参照されます。
同じグラフを、1人のユーザーの直接の関係に絞った表示。
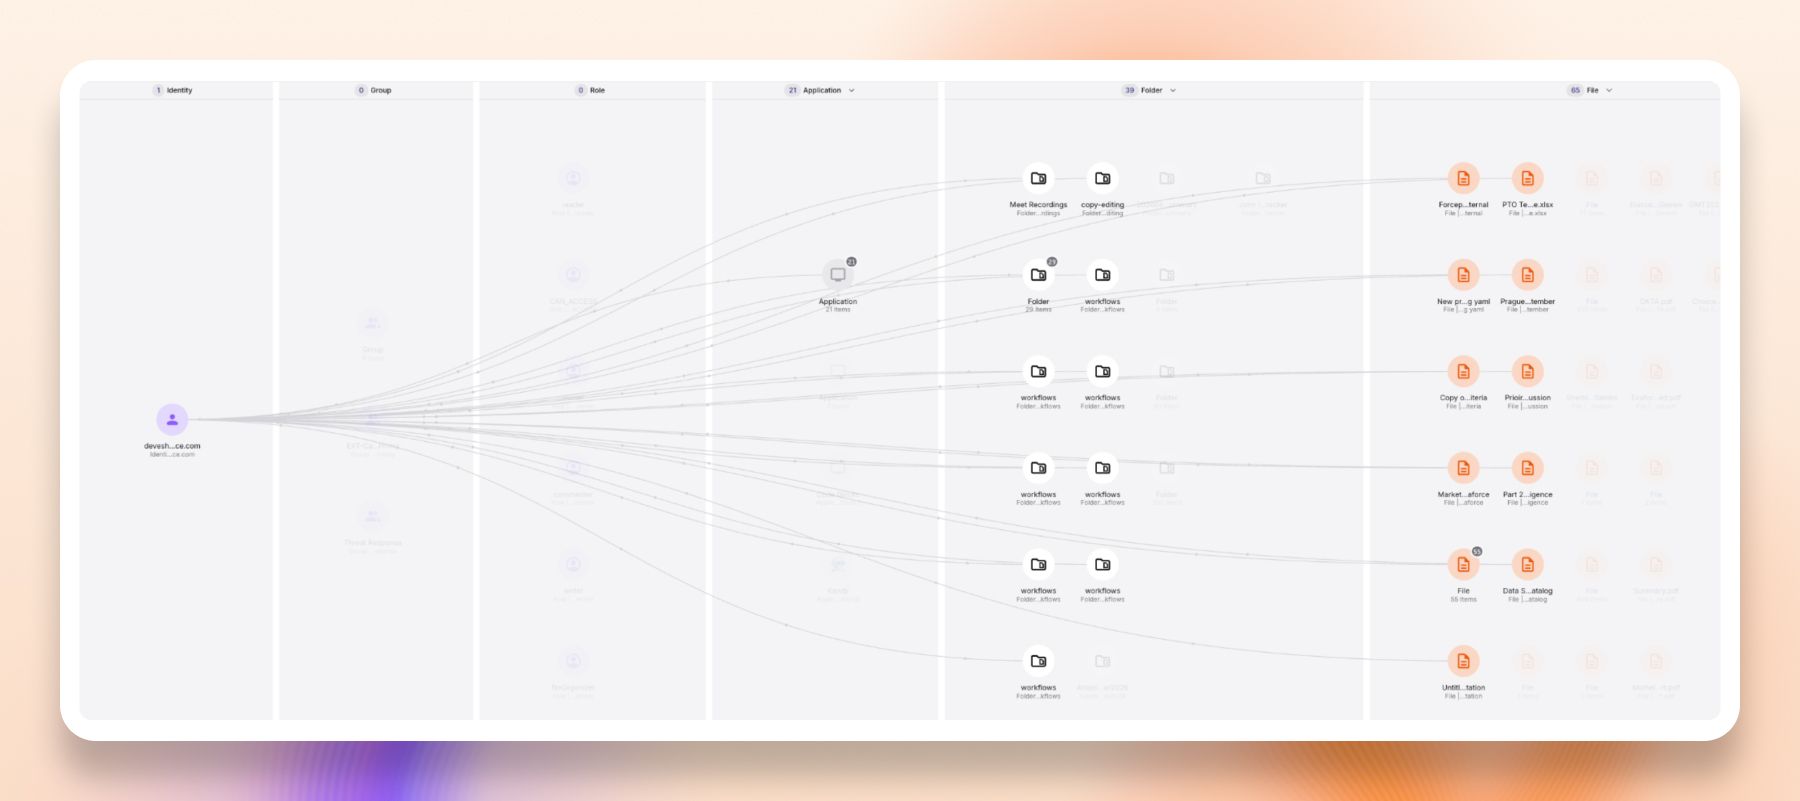
検出が発火するとき、システムはログを検索しません。グラフに問い合わせます。イベントが伝えるのは何が起きたかです。それ以外のすべて、つまり誰が関わっているのか、何にアクセスできるのか、履歴はどうなっているのか、そしてその組み合わせは普通なのか警戒すべきなのかを、グラフが伝えます。
このグラフは継続的に更新されます。OktaでユーザーのMFA登録が変われば、グラフに反映されます。MDMでデバイスが再割り当てされれば、グラフに反映されます。人事が誰かを退職として記録すれば、グラフに反映されます。検出ルールは常に現在の状態に対して評価され、誰かが最後にインポートを実行した時点の古いスナップショットに対してではありません。
深いポスチャ分析:ロールの適正化
設定の取得は、ユーザーに「管理者」か「管理者でない」かのラベルを付けるだけではありません。ユーザーの権限が実際の業務に見合っているかを判断できる深さまで、設定を分析します。
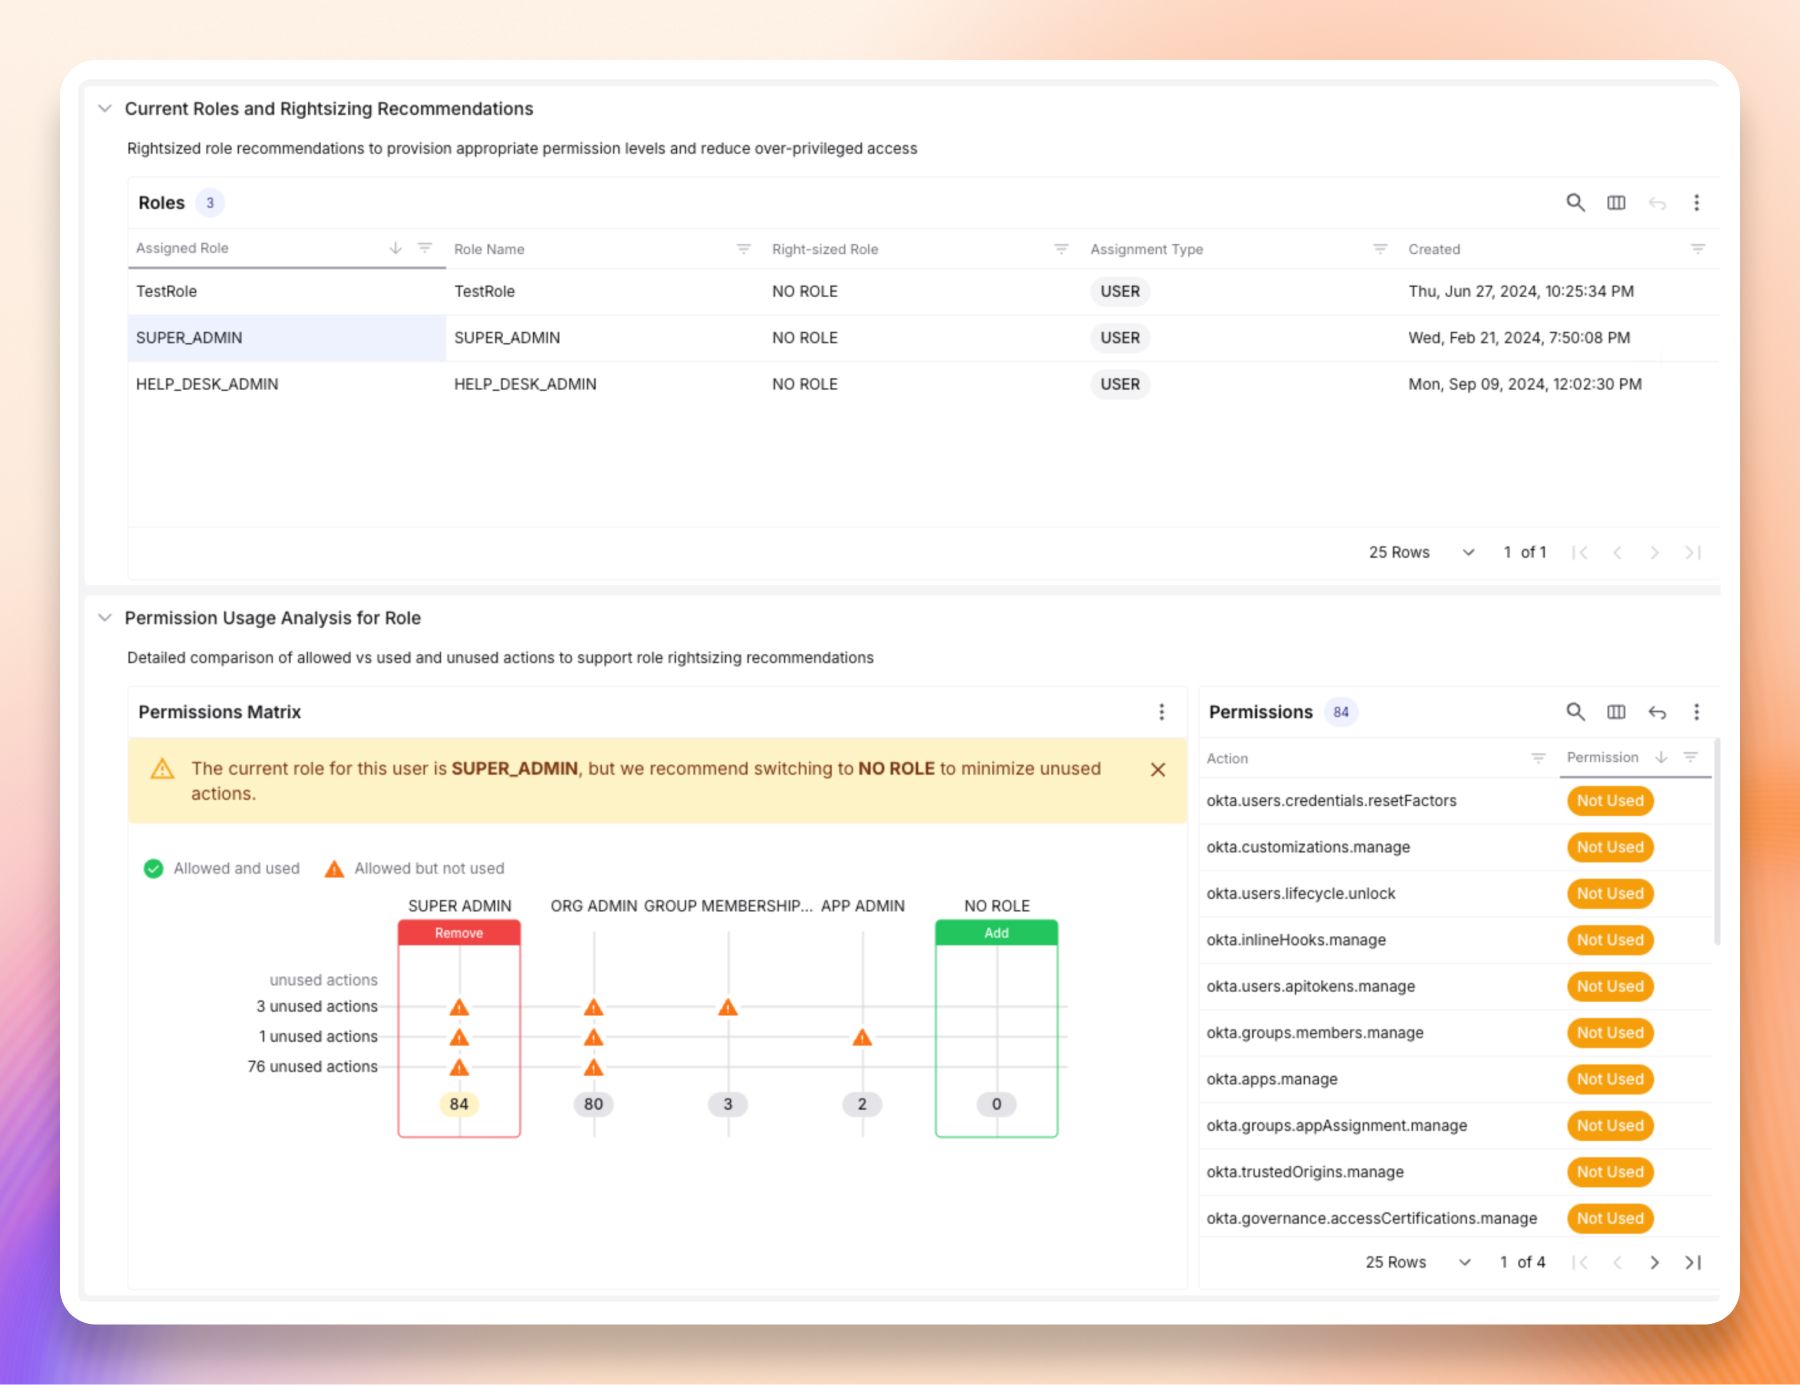
具体的な例を挙げます。あるOkta管理者がSUPER_ADMIN権限を持っています。システムはその管理者が過去90日間に実際に何をしたかを見ます。どの権限を使ったのか。ユーザーを変更したのか、アプリを管理したのか、ポリシーを変えたのか、それともレポートを閲覧しただけなのか。
管理者の実際の活動がHELP_DESK_ADMINやREAD_ONLY_ADMINの権限で足りるものだったなら、システムはこれを過剰な権限付与として検出し、適正化した具体的なロールを推奨します。検出結果は「この管理者のアクセスを見直してください」という曖昧なものではありません。「管理者JaneはSUPER_ADMIN権限を持っているが、過去90日間の実際の利用はHELP_DESK_ADMINで足りる。推奨される対応:ロールの格下げ」と伝えます。
1人のOkta管理者のロール適正化。割り当て済みのロール、各ロールが許可する権限、期間中に実際に使われた数、そして推奨される置き換え先。
同じ分析が、接続されたすべてのプラットフォームで実行されます。
- Okta:割り当てられた管理者ロールを実際の権限利用と比較します。ヘルプデスク操作しか行わないスーパー管理者、レポートの閲覧しかしないアプリ管理者、実際のAPI呼び出しに必要な範囲を超える権限を持つAPIサービス連携を検出します。
- GitHub:組織とリポジトリの管理者ロールを実際の活動と比較します。管理者レベルの操作を一度も使わない管理者、コミットとレビューのパターンを超える過剰な権限を持つリポジトリ管理者、管理者権限を持つ外部コラボレーターを検出します。
- Azure AD / Entra:ディレクトリロールの割り当てを実際の利用と比較します。観測された権限のパターンに基づいて、具体的なロールの格下げを推奨します。
- Google Workspace:同じパターンです。割り当てられたロールを権限の利用と比較し、適正化した代替案を推奨します。
- AWS:IAMポリシーを分析し、未使用の書き込み権限を持つアクティブなアイデンティティ、未使用のlist/read/tagging権限、本来SSOを使うべきなのにアクセスキーを持っている人間のユーザーを見つけます。
これが、設定を収集するだけでなく分析するということです。システムは各プラットフォームの権限モデルを理解し、どの権限が時間とともに実際に行使されているかを観測し、付与されたアクセスと必要なアクセスの間のギャップを特定します。そのギャップこそが、組織が過剰にプロビジョニングし、片付けを忘れるたびに静かに広がっていく攻撃対象領域です。
コンテキストが検出に入る仕組み
こうしたコンテキストのすべて、つまりアイデンティティのポスチャ、権限、デバイスの状態、リソースの機密度、ふるまいのベースライン、適正化分析は、評価の時点で検出エンジンから利用できます。
検出が一連のイベントを評価するとき、見ているのはイベントだけではありません。次のものも見ています。
- アイデンティティのポスチャ:この人物は管理者か。サービスアカウントか。契約社員か。強固なMFAを持っているか。過剰にプロビジョニングされていないか。新入社員か、10年目のベテランか。高リスクとしてフラグが立てられていないか。
- リソースの機密度:そのS3バケットにはPIIのタグが付いているか。そのコードリポジトリは本番にとって重要か。そのDriveファイルは外部と共有されているか。
- ロケーションとネットワークの履歴:このユーザーをこのASNから見たことがあるか。この都市は。組織全体のベースラインと比べてどうか。
- デバイスの状態:そのデバイスはMDMに登録されているか。EDRエージェントは正常か。ユーザーに割り当てられたデバイスか。
- ふるまいのベースライン:この特定のユーザー、この特定のエンドポイント、この特定のAPIにとっての「普通」とは何か。
- 調査の状態:このユーザーはすでに調査中か。過去の検出結果は誤検知としてクローズされているか。
つまり、同じふるまいの異常でも、コンテキストによって結果は変わります。弱いMFAしか持たない過剰にプロビジョニングされたスーパー管理者による新しいASNからのログインは、管理対象デバイス上で強固なMFAを持つ読み取り専用ユーザーによる同じログインとはまったく異なるシグナルです。検出エンジンがその違いを知っているのは、ナレッジグラフが教えてくれるからです。
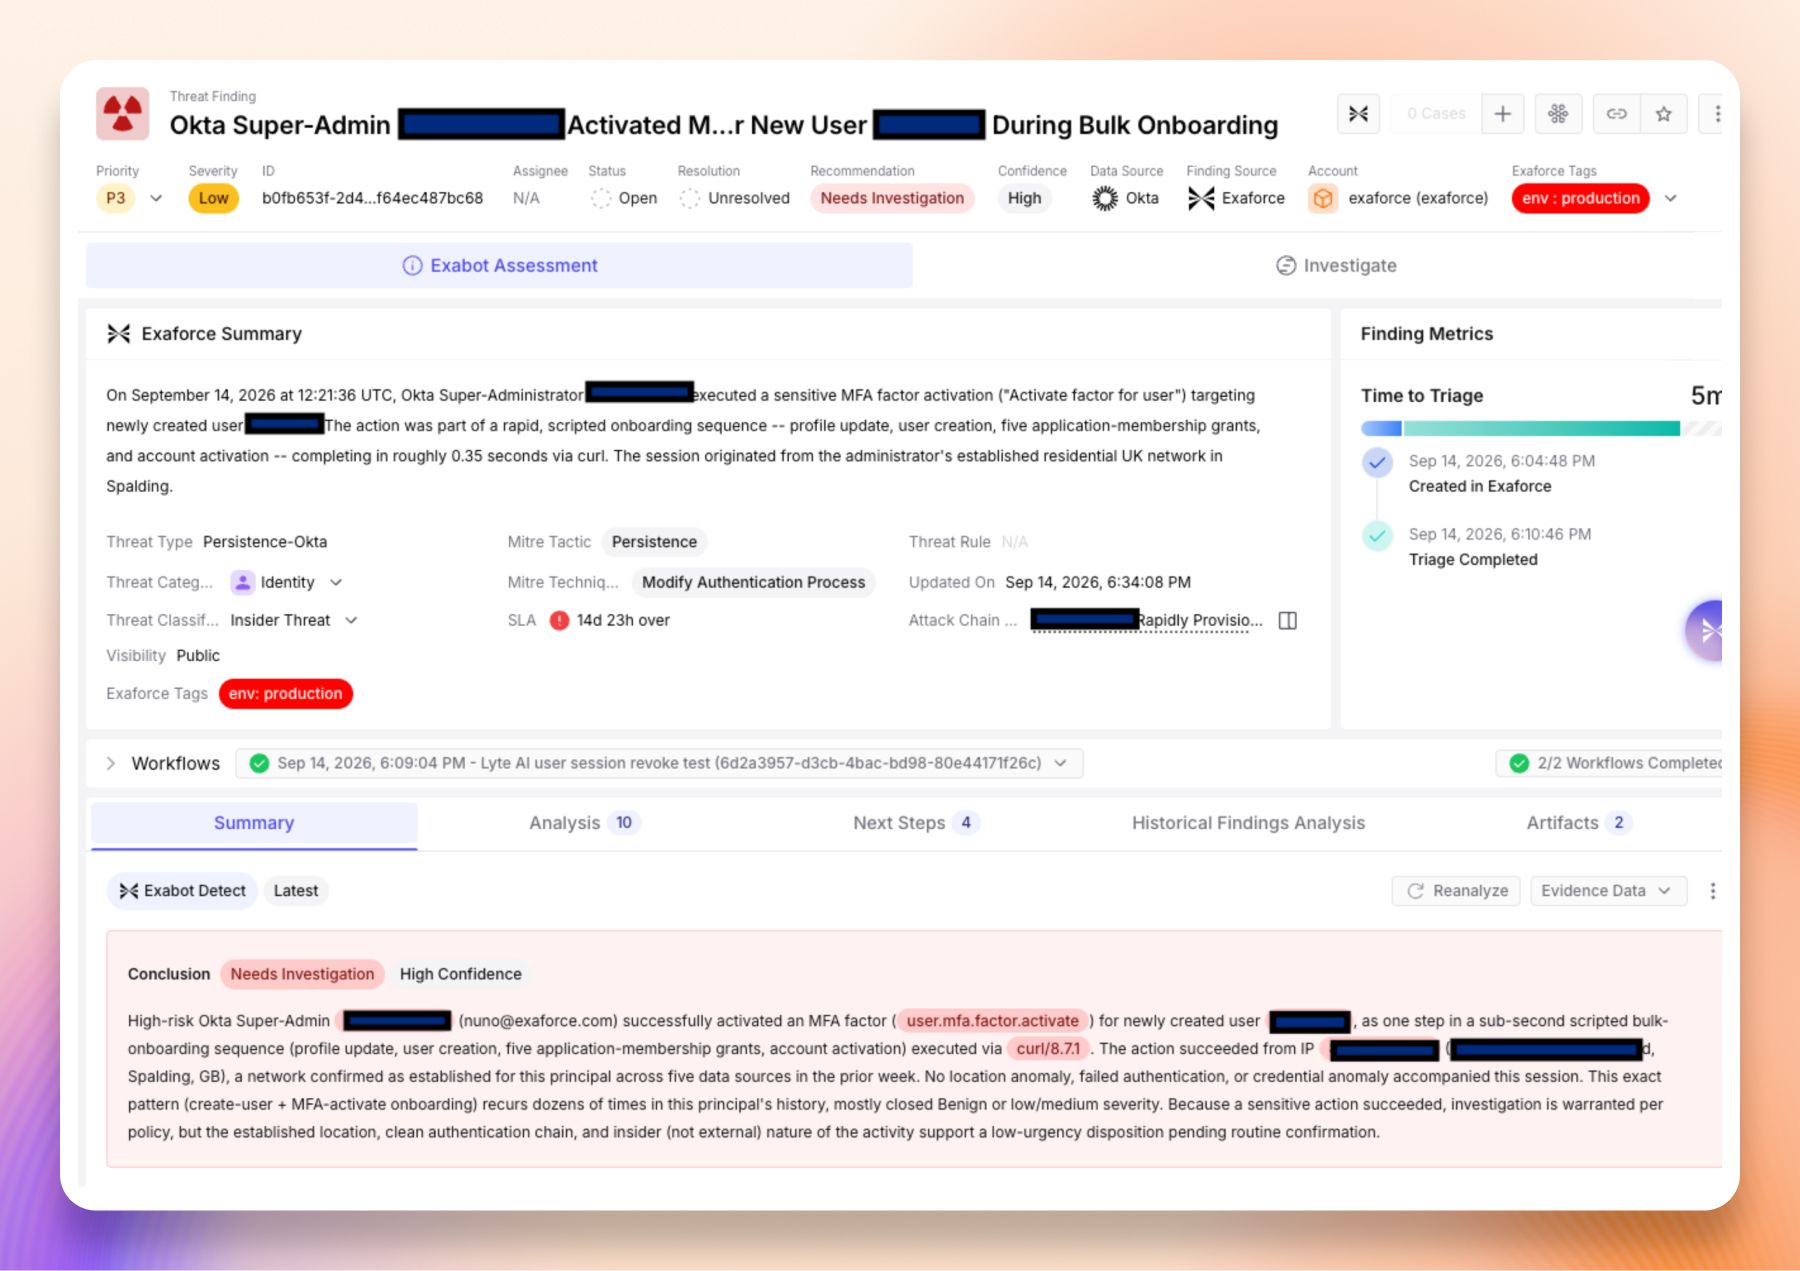
コンテキストが結果を決める例。一括オンボーディング中にスーパー管理者が新規ユーザーのMFA要素を有効化した操作は、ロケーション、デバイス、セッション履歴がその管理者にとって通常どおりであるため、低と評価されています。
学習するふるまいのベースライン
静的な検出ルールの寿命は短いものです。許可リスト外の国からのログインを検出するルールは、誰かが新しい場所へ出張し始めるまでは機能します。1分あたり100回のAPI呼び出しというしきい値は、あるチームが新しいCI/CDツールを導入してアラートが一日中鳴り続けるまでは妥当に見えます。
エクサフォースは静的なしきい値を、何が普通かを学習し、環境の変化に適応するふるまいのベースラインに置き換えます。ベースラインは、ナレッジグラフのあらゆる重要な次元について構築されます。
- ユーザーとアイデンティティ:ユーザーがどのASNと都市から接続するか、どのイベントタイプを生成するか、どのツールとユーザーエージェントを使うか、活動の頻度と典型的な勤務時間、どのリソースにアクセスするか。Janeが常にニューヨークのComcastからmacOS上のChromeを使っているなら、フランクフルトのHetznerからのpython-requestsによる呼び出しは目立ちます。フランクフルトがブロックリストに載っているからではなく、Janeにとっての普通ではないからです。
- サブプリンシパル(OAuthアプリ、APIトークン、サービスアカウント、AIエージェント):それらが属する人間とは別のベースラインを持ちます。各トークンがどのリソースに、どの頻度で、どのIPからアクセスするか。突然ソースコードのリポジトリを読み始めたバックアップ用トークンには、所有者のものとは別の、トークン自身の異常があります。
- APIエンドポイント:リクエストレート、期待されるパラメータと型、レスポンスコード、各エンドポイントを呼び出すクライアント。5xxエラーの急増や、見慣れないパラメータを持つリクエストの集中は、そのエンドポイント自身の履歴に対して検出されます。
- リソース(リポジトリ、ファイル、バケット、アプリケーション):各リソースに通常誰が、どの頻度で、どの操作でアクセスしているか。通常は3つのIAMロールから1日10回の読み取りがあるS3バケットは、4つ目のロールが一括ダウンロードを始めると目立ちます。
- IPアドレスとネットワーク:各ASNから通常どのユーザーと組織が接続しているか。あるVPNプロバイダーが社内で一般的なのか、初めて見るものなのか。送信元IPが脅威活動と関連付けられたことがあるか。
- デバイス:各デバイスで通常どのプロセスが動き、どのユーザーがログインし、どのネットワークから接続し、どのようなソフトウェアがインストールされているか。デバイス上の新しいプロセスや見慣れないログインユーザーは、そのデバイス自身のベースラインに対して検出されます。
- 組織とアカウント:2つ目のコンテキスト層となる、アカウント全体のパターン。特定のユーザーにとっては新しいが組織全体では一般的なASNは、誰も見たことのないASNより懸念は小さくなります。
すべてのベースラインは、データが十分かどうかで制御されます。履歴が浅いユーザー、エンドポイント、リソース、つまり新入社員、新しく作られたリポジトリ、最近接続したデータソースについて、システムは異常を検出しません。この方式なら、新しい連携を追加してもアラートの嵐は起きません。システムは自分がまだ十分に知らないことを知っていて、十分に知るまで待ちます。
これによって可能になること
コンテキストが豊富な検出が実際にどのようなものか、いくつか例を挙げます。網羅的なリストではなく、ナレッジグラフが検出できるものをどう変えるかを示す例です。
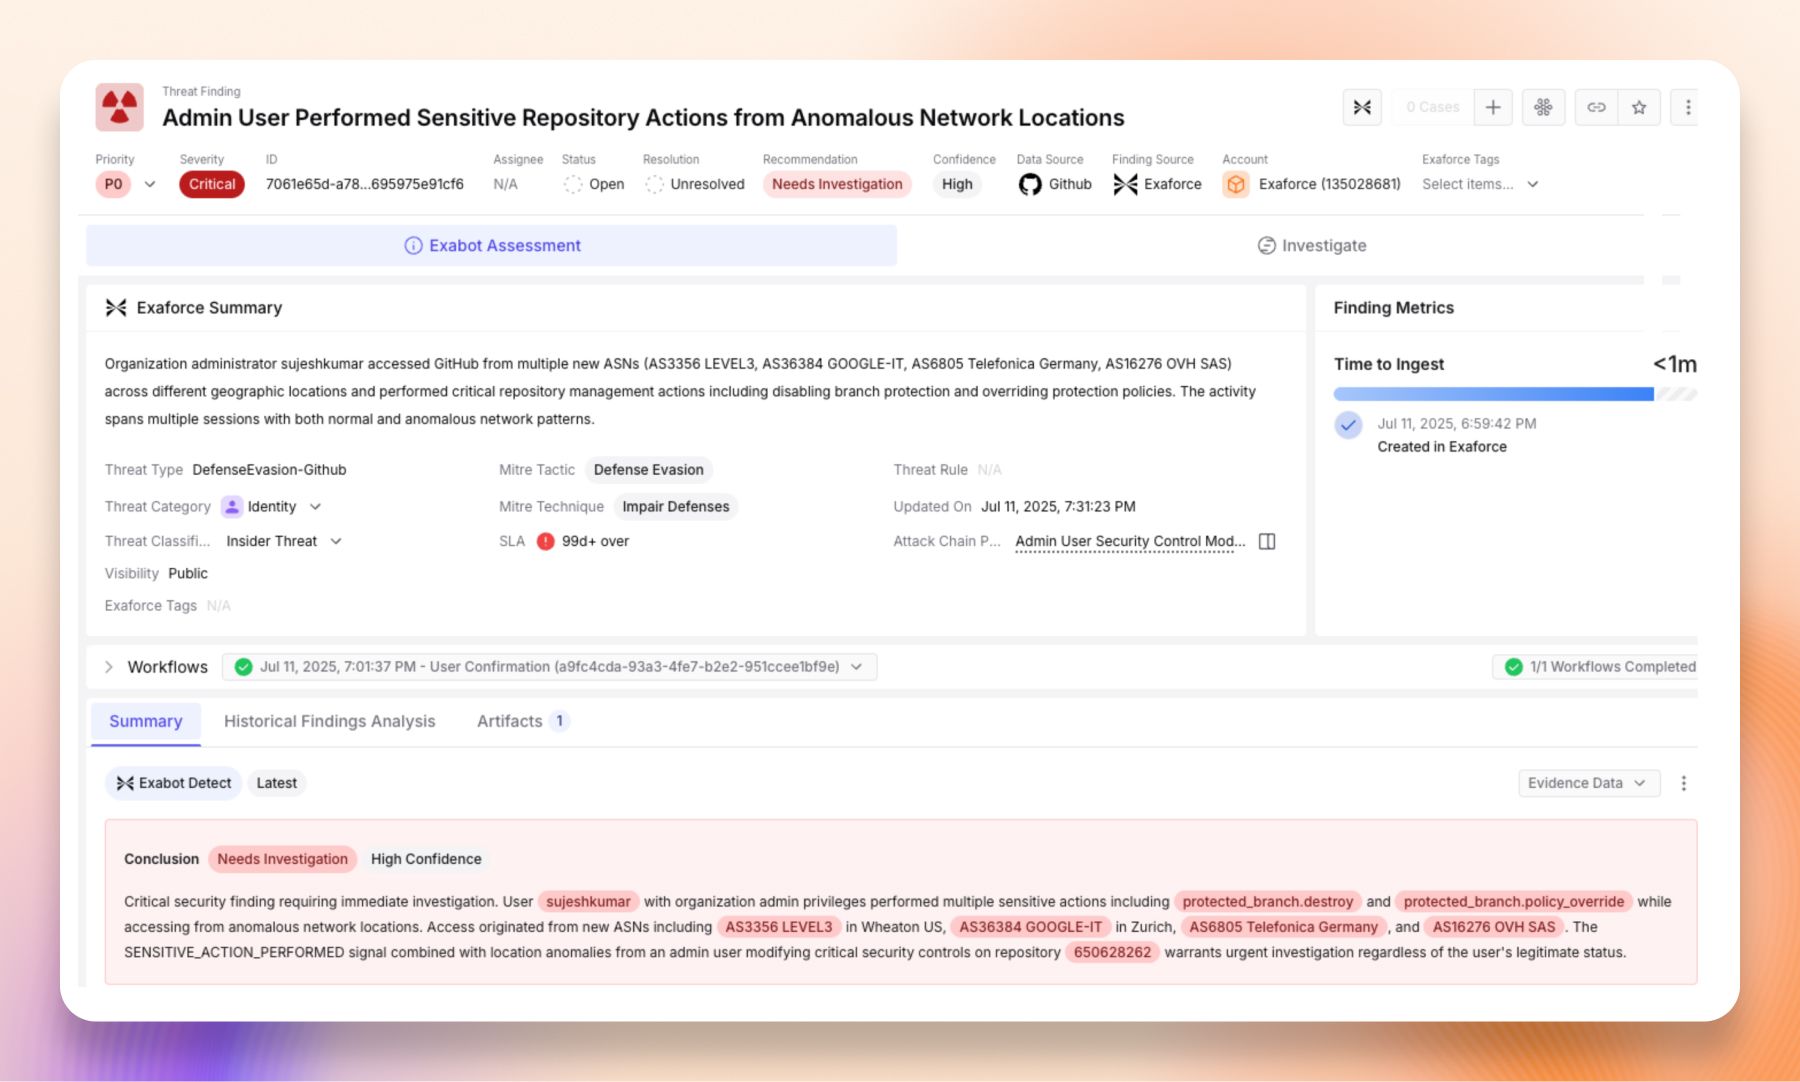
過剰にプロビジョニングされた管理者が、見慣れないネットワークからログインし、機密性の高い操作を行う。システムは、SIEMが知らない3つのことを知っています。(1) この管理者のロールは実際の利用に基づいて読み取り専用に適正化されるべきだったこと、(2) そのネットワークはユーザーにとっても組織にとっても新しいこと、(3) 行われた操作は、このユーザーが90日間行使していない管理者レベルの操作であること。それぞれの事実が深刻度を引き上げます。合わせれば、信頼度の高い複合シグナルになります。
複合シグナルの例。組織の管理者が、ユーザーにとっても組織にとっても見たことのないネットワークから、機密性の高いリポジトリ操作を行っています。
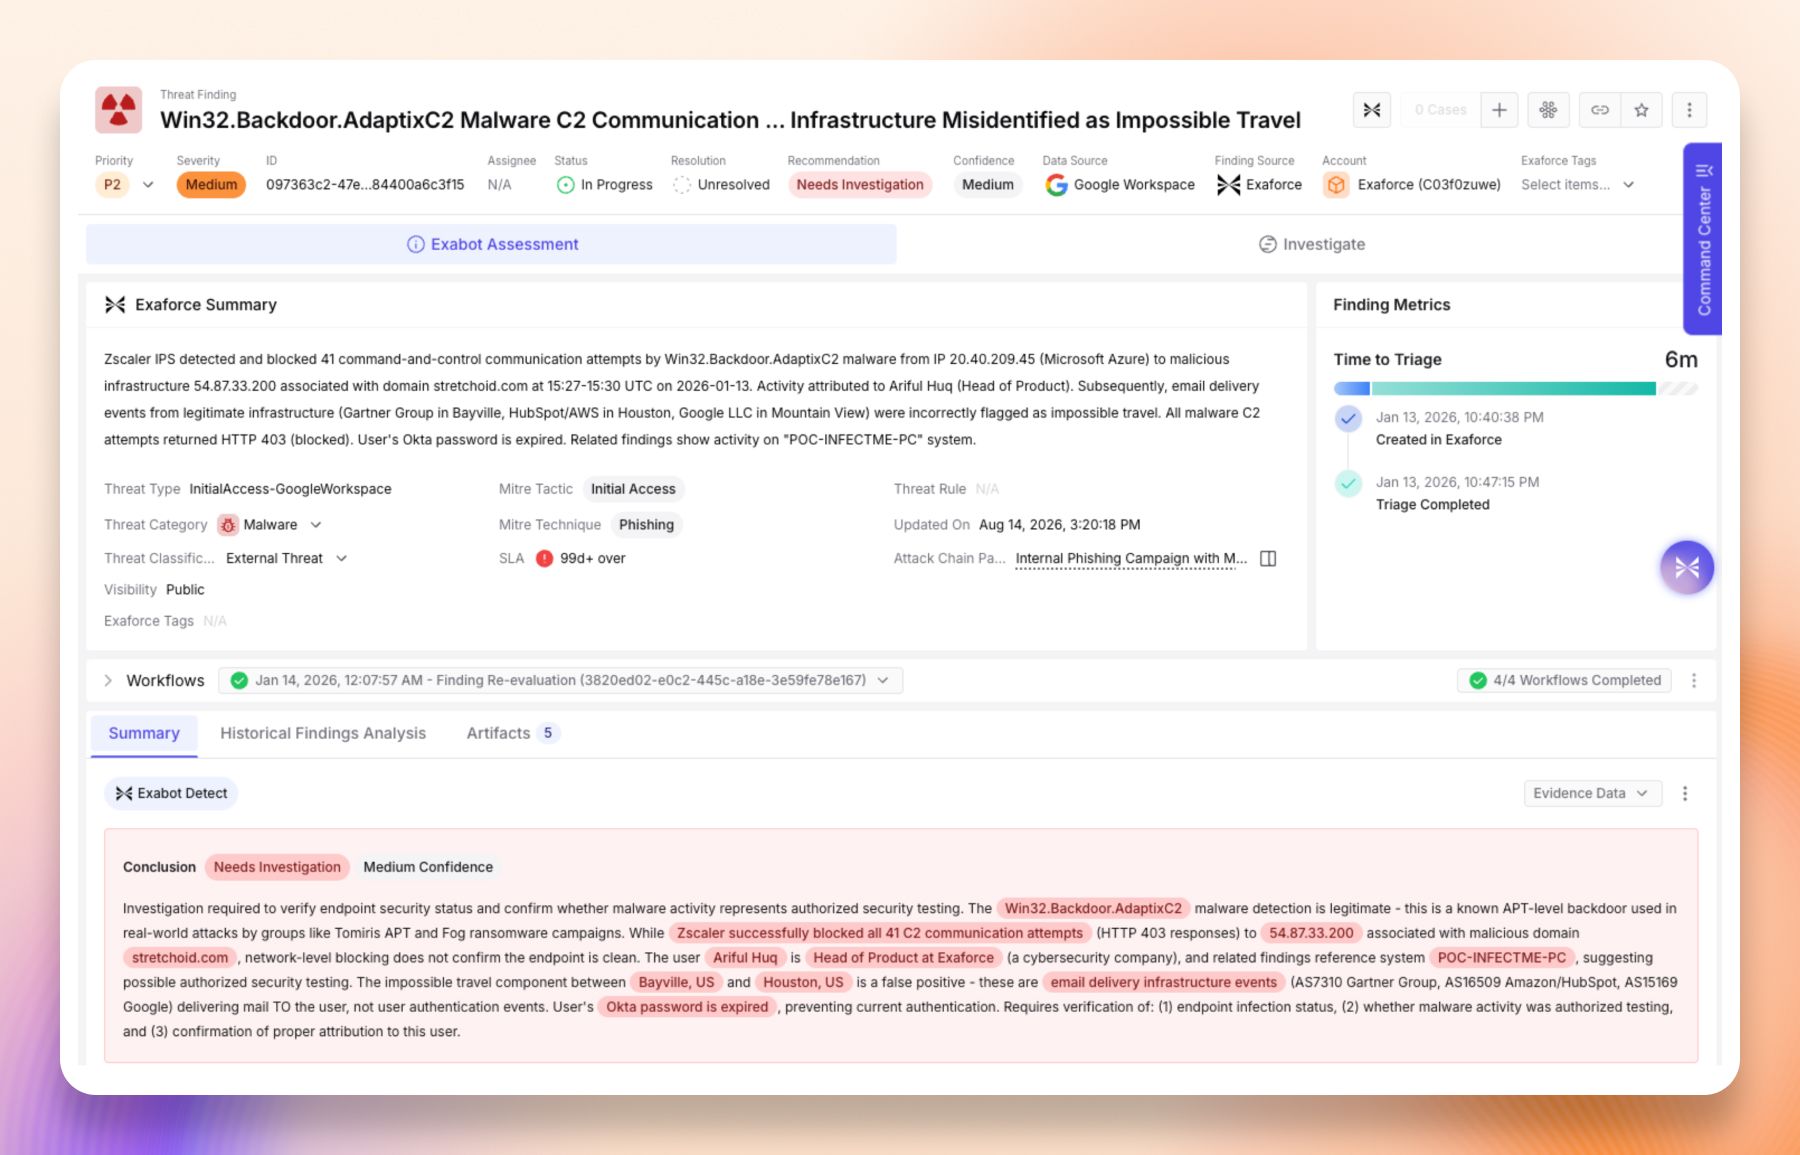
フィッシングメールが届き、数分後に受信者のデバイスでマルウェアが検出される。メールセキュリティシステムはフィッシングを見ています。EDRシステムはマルウェアを見ています。ナレッジグラフがユーザーとデバイスを(MDMを通じて)結び付けているため、システムは完全なチェーンを組み立てます。メールの配信、添付ファイルの開封、不審なプロセスの起動、外部へのC2接続。1つの検出結果、1つのストーリーです。
1つの検出結果、1つのストーリー。マルウェアのコマンド&コントロール通信の検出が、その背後にいるユーザーとデバイスに結び付けられています。
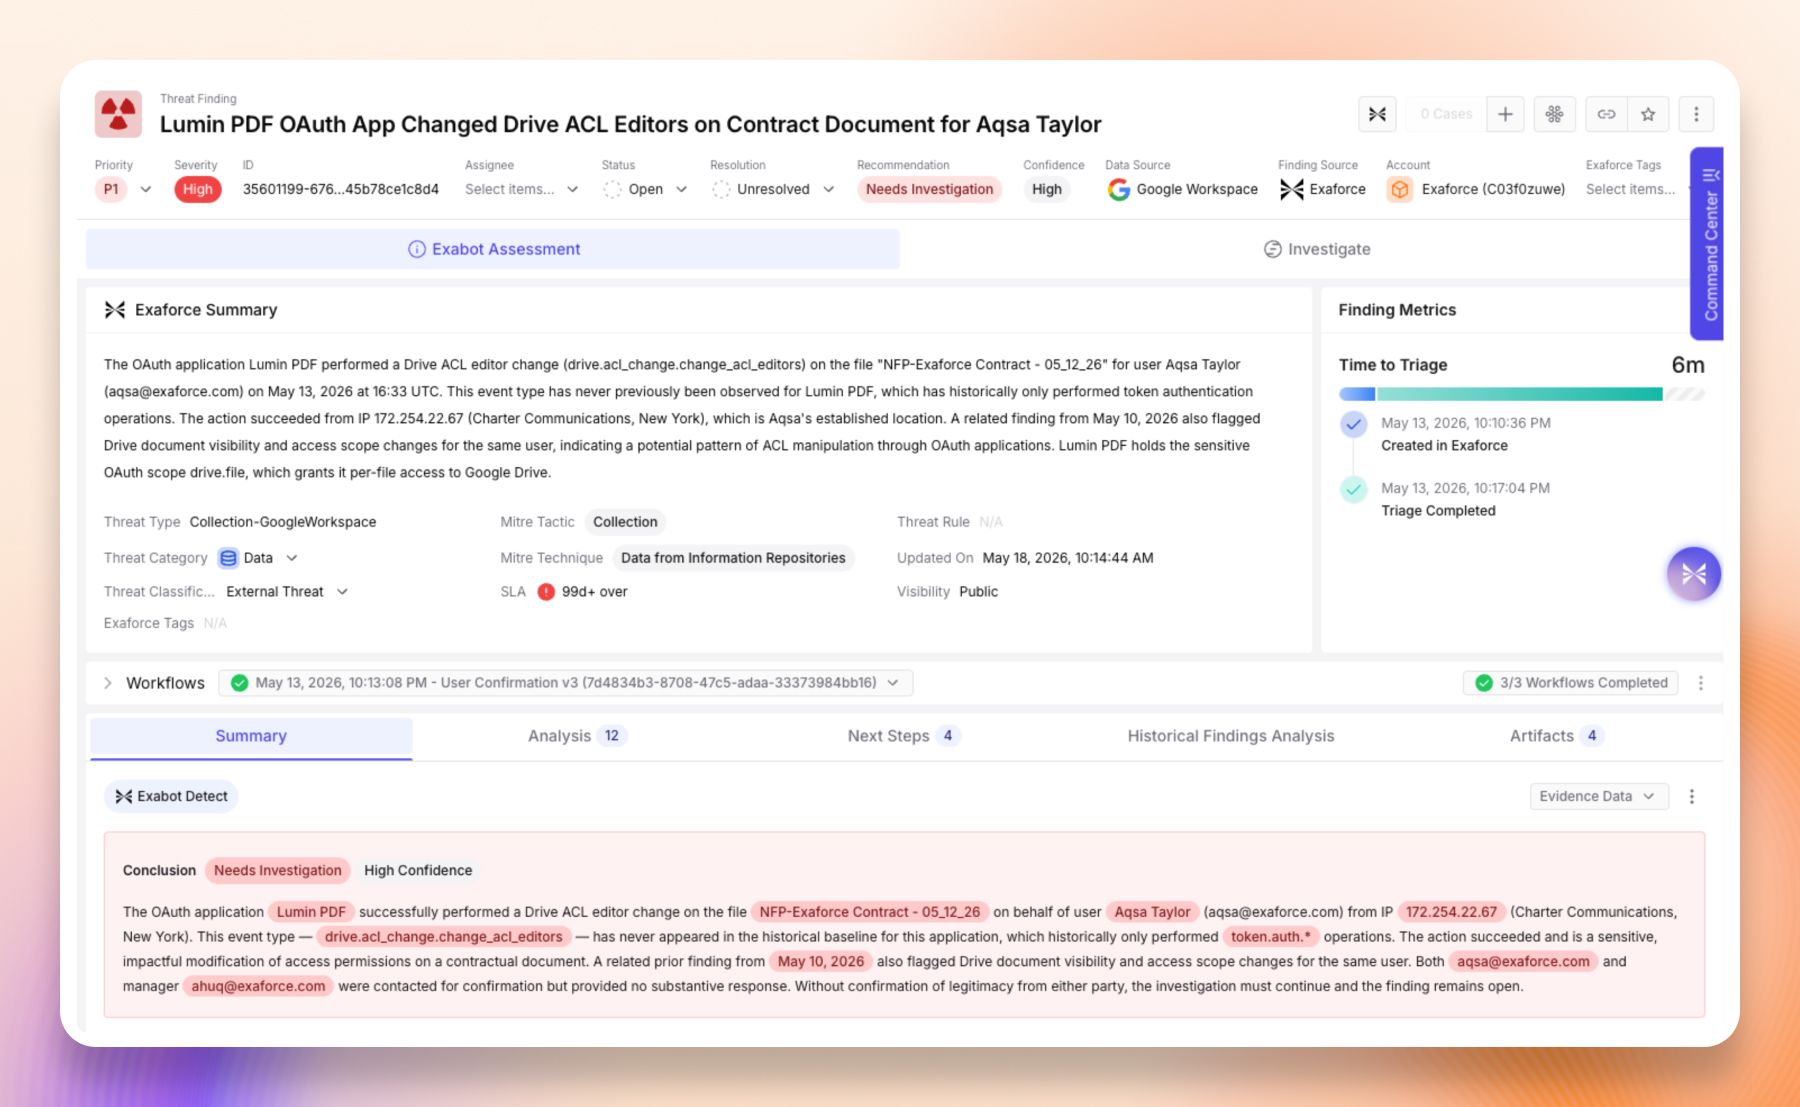
OAuthトークンが、これまでのパターンから外れたリソースにアクセスし始める。すべてのイベントにサブプリンシパルがラベル付けされているため、システムはトークンとOAuthアプリごとに別々のベースラインを構築します。バックアップツールのトークンが、それまで一度も触れたことのないソースコードリポジトリを突然読み始めると、その異常はトークンのベースラインに対して検出され、人間のユーザーの活動と混同されることはありません。
サブプリンシパルの検出例。OAuthアプリがDriveドキュメントの共有設定を変更した操作が、所有者ではなくアプリ自身のベースラインに対して検出されています。
学習したコントラクトに一致しないパラメータを持つAPIリクエストが届く。システムは各エンドポイントにとっての「普通」、つまり期待されるパラメータ、型、ヘッダーを知っています。SQLインジェクションの構文を含む未知のパラメータを持つリクエストは検出されます。WAFのシグネチャに一致したからではなく、そのパラメータがAPIの観測されたコントラクトに一度も含まれていなかったからです。
休眠状態だったユーザーが新しい都市から活動を始め、数分以内に管理者操作を行う。システムは3つの次元を相関させます。90日以上の非活動、このユーザーにとっても組織にとっても見たことのない都市、そしてログインから10分以内の機密性の高い管理者操作です。どれか1つなら無害かもしれません。アイデンティティのポスチャとベースラインの履歴に対して評価されたその組み合わせは、信頼度の高い指標です。
個々のシグナルから攻撃チェーンへ
個々の検出シグナルは有用ですが、最も危険な脅威が単一の異常として現れることはめったにありません。脅威は一連のイベントのチェーンとして展開します。普段と異なる場所からのログインが権限昇格につながり、それが機密データへの扉を開き、そのデータが静かに持ち出される。これらのステップは、単独で見ればどれも深刻度が低く見えるかもしれません。まとめて見たときに初めて、本当の脅威の輪郭がはっきりします。
単一のデータソースの中では、ナレッジグラフによってシステムはこうしたチェーンを認識できます。同じアイデンティティについて一定の時間枠の中で複数のシグナルが発火したとき、システムはそれらを独立したアラートとして扱いません。ひとつの進行として評価します。
Oktaにおける認証情報侵害のパターン:新しいASNからのログイン(低シグナル)、続いてMFA疲労を狙ったプッシュ通知の連打(中シグナル)、続いて認証の成功(プッシュが承認されたことの裏付け)、続いて管理者ロールの変更(高シグナル)。4つのイベント、1つのストーリー。誰かがMFAを総当たりで突破し、権限を昇格させたのです。
Google Workspaceにおける内部者によるデータの集積:あるユーザーが通常の10倍のペースでファイルをダウンロードし始め(中シグナル)、それまでアクセスしたことのないフォルダから(中シグナル)、しかもブラウザではなくDrive APIの利用に切り替わっている(低シグナル。サブプリンシパルのラベル付けが人間とアプリの活動を区別するため検出可能)。個別に見ればどれも新しいプロジェクトかもしれません。合わせて見ると、持ち出し前のデータ集積のパターンに一致します。
アクセスログにおけるAPI探査のシーケンス:複数のエンドポイントに対するパストラバーサルの試行(中シグナル)、続いてクエリパラメータにインジェクションのペイロードを含むリクエスト(中シグナル)、続いて特定のエンドポイントでの5xxエラーの急増(中シグナル)。すべて同じ送信元IPから1時間以内に発生。このシーケンスは、偵察から悪用への進行に対応します。
チェーン検出を可能にしているのはナレッジグラフです。アイデンティティの解決がなければ、4つのOktaイベントを同じ人物に結び付けられません。サブプリンシパルのラベル付けがなければ、DriveでのブラウザからAPIへの切り替えは見えません。APIエンドポイントのベースラインがなければ、探査のシーケンスは通常のトラフィックの揺らぎにしか見えません。
しかし、単一ソースのチェーンには限界があります。実際の攻撃はアプリケーションの境界を越えます。あるプラットフォームから別のプラットフォームへ、あるアイデンティティから別のアイデンティティへ、しかもすべてが同じ人物に属しています。第4回では、すべてのアイデンティティが単一のEnterprise Userに解決されたとき、ソースを横断したチェーン検出がどのように機能するかを紹介します。
これらが意味すること
設定、エンリッチメント、学習したベースラインから構築されるナレッジグラフこそが、「このイベントが起きた」と「このイベントは重要だ」を分けるものです。
SIEMやサードパーティの検出システム(エンドポイント、ネットワーク、アイデンティティなど)は、あらゆる異常についてアラートを上げ、それが重要かどうかの判断をアナリストに委ねます。エクサフォースは、それぞれの異常を完全なコンテキスト、つまりアイデンティティのポスチャ、適正化された権限、リソースの機密度、デバイスの状態、ふるまいの履歴、調査の状況に照らして評価します。その結果、検出結果はより少なく、信頼度はより高く、裏付けとなるコンテキストはすでに揃った状態になります。
しかし、こうした検出はまだ、個々のデータソースと個々のアイデンティティの範囲内で行われています。高度な攻撃は境界を越えます。あるアプリケーションから別のアプリケーションへ、あるアイデンティティから別のアイデンティティへ、しかもすべてが同じ人物に属しています。次回は、エクサフォースがアプリケーションごとのすべてのアイデンティティを単一のEnterprise Userに解決し、単一ソースのツールには不可能なソース横断の検出を実現する仕組みを紹介します。
次回:第4回 — Enterprise User:1人の人物、すべての脅威