セキュリティ運用をゼロから見直すシリーズの第2回。
第1回では、SIEMの根本的な問題はコンテキストの欠如にあると論じました。SIEMはログを取り込みますが、そのログが記述しているアイデンティティ、デバイス、リソース、そしてそれらの関係を理解していません。基盤がナレッジグラフではなくテキストインデックスであるために、その上に乗るすべての機能(検出、調査、脅威ハンティング)が影響を受けます。
今回は、その基盤を立て直す話です。コンテキストが豊富な検出を実現したいなら、コンテキストが豊富なデータが必要です。そしてそれは、生ログを機械やアナリストが推論できる形に変換する方法から始まります。
フィールドマッピングでは不十分な理由
最初のステップとして分かりやすいのは正規化、つまりベンダー固有のフィールドを共通スキーマにマッピングすることです。Oktaのclient.ipAddressはsource_ipになり、Google WorkspaceのipAddressもsource_ipになります。これで解決、のように見えます。
しかし、そうはなりません。フィールドマッピングが与えてくれるのは共通の列名であって、意味ではありません。2つのイベントが同じsource_ip列を持つと分かっても、それがログインなのか、ファイルアクセスなのか、API呼び出しなのか、ファイアウォールのブロックなのかは何も分かりません。列名は、そのアクションが機密性の高いものかどうか、プリンシパルが人か機械か、アクセスされているリソースに顧客のPIIが含まれるかどうかを教えてくれません。
もう一つの誘惑は、すべてのデータ型に単一のスキーマを使うことです。すべてを1つのスキーマで統べる、という発想です。このアプローチは別の理由で失敗します。SaaS監査ログのセキュリティ上重要な構造は、EDRのプロセスイベントやHTTPアクセスログの構造とほとんど共通点がありません。無理に同じ形に押し込めれば、重要なフィールドが失われるか、ほとんどの場合にnullになる列でイベントが埋め尽くされることになります。
オープンなカテゴリーベースのスキーマのように、イベントクラスごとに独自の形を与えれば、null列の問題は軽くなります。しかし意味の問題は解決しません。スキーマが定義するのは構造であって、判断ではありません。あるイベントがアイデンティティ管理の操作であることは表現できても、ユーザーの停止はセキュリティ機密度がCRITICALであり、レポートのエクスポートはMEDIUMである、とは表現できません。重要なのは、その判断をどう埋め込むかです。
エクサフォースは異なるアプローチを取っています。セキュリティデータの種類ごとに用意した専用のセマンティックモデルです。各モデルは、そのデータ型の意味を捉えます。フィールドだけでなく、脅威検出においてそれが何を表しているかまでを含みます。現在、モデルはSaaS監査ログ、HTTPアクセスログ、EDRのエンドポイントテレメトリ、フォワードプロキシのトラフィック、ネットワークファイアウォールのフローをカバーしており、さらに追加が進んでいます。データ型ごとにモデルを分けているのは、それぞれが根本的に異なるセキュリティ領域を表しているからです。
SaaS監査ログ:誰が、何に対して、何をしたか、どこから
サポート対象のあらゆるSaaSアプリケーション(Okta、Google Workspace、Slack、GitHub、Microsoft 365、Salesforce、1Password、Atlassianなど)から届く監査ログは、すべて単一のセマンティックモデルに正規化されます。
プリンシパルが、ロケーションから、リソースに対してアクションを実行し、結果を返す
次のOktaイベントを見てください。
これが、こうなります。
ロケーションの行は、生のイベントには含まれていませんでした。これはジオIPエンリッチメントによるもので、すべてのモデルのすべてのイベントに対して実行されます。
この変換は、単なるフィールド名の付け替えではありません。次の3点が決定的に違います。
キュレーションされたイベント分類。 エクサフォースは、SaaSソース全体で数千件規模のイベントタイプのマッピングを維持しています。ベンダーの生イベントはそれぞれ、AUTHENTICATION.LOGIN、ADMINISTRATIVE.ROLE_MANAGEMENT、DATA_LOSS_PREVENTION.FILE_DOWNLOADといった標準化されたカテゴリーに分類され、INFOからCRITICALまでの機密度が付与されます。Oktaのaccess.request.condition.deleteは機密度HIGH、analytics.reports.export.generateはMEDIUMです。これらは自動生成されたものではなく、セキュリティのドメイン知識をデータ層に埋め込むためにキュレーションされた分類です。
可搬性のある検出。 すべてのSaaSイベントが同じ言語を話すようになれば、検出ロジックはベンダーに依存しなくなります。「休眠ユーザーが新しい場所から機密性の高い操作を実行している」という検出は、Okta、Microsoft Entra ID、Google Workspace、Slackで同じように機能します。ベンダーごとの変種は必要ありません。ベンダーがスキーマを変更した場合も、マッピングを一度更新するだけで、検出そのものは変わりません。
サブプリンシパルのラベリング。 すべてのイベントには、人が直接操作したのか、サブプリンシパル(OAuthアプリ、APIトークン、サービスアカウント)が本人に代わって操作したのかというタグが付きます。SIEMは「Janeが500件のファイルを削除した」と表示しますが、それがJane自身の手による削除なのか、週に一度本人に代わって動くクリーンアップアプリによるものなのかは区別しません。実行したアプリはログのJSONの奥深くにある生フィールドのどこかに入っているかもしれませんが、それにラベルを付けるものは何もありません。エクサフォースは、Janeがブラウザーでファイルを削除する場合と、サードパーティのバックアップアプリが彼女のOAuth権限付与を通じて削除する場合を区別します。
人が起点のアクションとアプリが起点のアクションは、脅威プロファイルが根本的に異なります。人が大量のファイルをダウンロードしていれば、インサイダー脅威かもしれません。バックアップアプリが同じことをスケジュールどおりに行っているなら、それは日常業務です。検出は適切な行為者を狙い撃ちできます。人に限定した検出は自動化されたノイズを除外し、サブプリンシパル専用の検出はOAuthアプリやトークンの挙動の異常、たとえばそれまで一度も触れたことのないリソースに急にアクセスし始めたトークンなどを捉えます。
HTTPアクセスログ:APIの露出面を明らかにする
リバースプロキシとAPIゲートウェイのログは、まったく別物です。大量かつステートレスで、脅威の対象は多くの場合アイデンティティではなくAPIエンドポイントやドメインです。
エクサフォースはHTTPログを、リクエストを中心としたモデルに正規化します。
IPが、ドメイン上のエンドポイントにメソッドを送信し、ステータスを受け取る
このイベントは出発点にすぎません。価値があるのは、そこから導き出される2つのこと、つまりリクエストが実際にどのエンドポイントに当たったのか、そしてそのエンドポイントへの通常のリクエストがどのようなものかです。
エンドポイントの自動検出
アプリケーションは数百のAPIエンドポイントを公開していますが、SIEMに見えるのは生のURLだけで、そこには一意のID、セッショントークン、クエリ文字列が埋め込まれています。同じエンドポイントへの2つのリクエストが、まったく別の文字列に見えてしまいます。
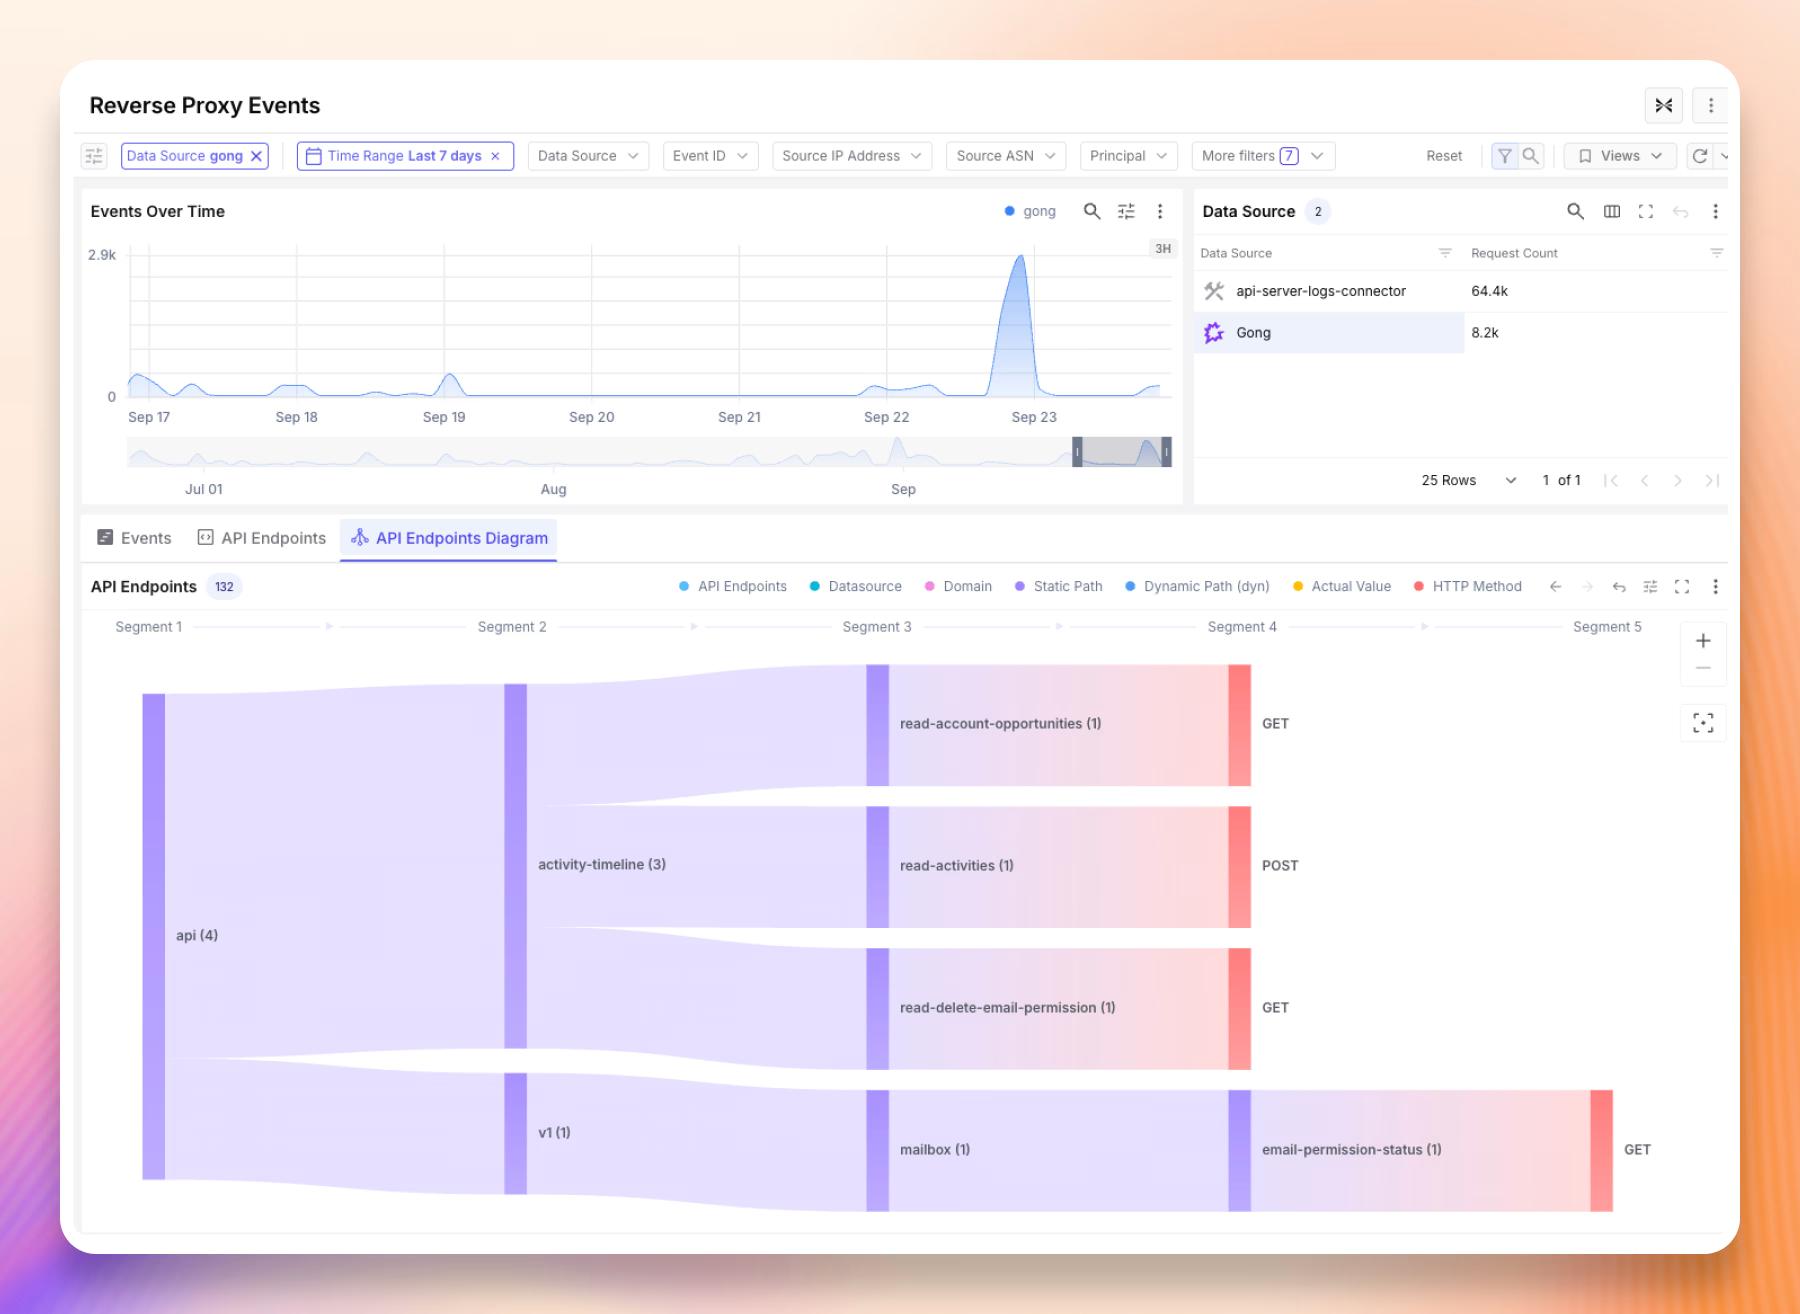
エクサフォースは、実際のトラフィックからAPIの露出面を自動的に検出して正規化します。/api/users/550e8400-e29b-41d4/postsと/api/users/a1b2c3d4-ef56-7890/postsのようなURLは、同一のエンドポイント/api/users/{id}/postsとして認識されます。手動設定も、OpenAPI仕様のインポートも、開発者の関与も必要ありません。実際にAPIに届いているトラフィックから、システムがAPIのトポロジーを学習します。
つまりSOCアナリストは、どのAPIエンドポイントが存在し、それぞれがどれだけのトラフィックを処理し、通常のリクエストパターンがどのようなものかを、誰も文書化していなかった場合でも把握できます。
1つのデータソースで検出されたAPIトポロジー。エンドポイントがホスト、パスセグメント、HTTPメソッドごとに枝分かれしている。
APIコントラクトの自動学習
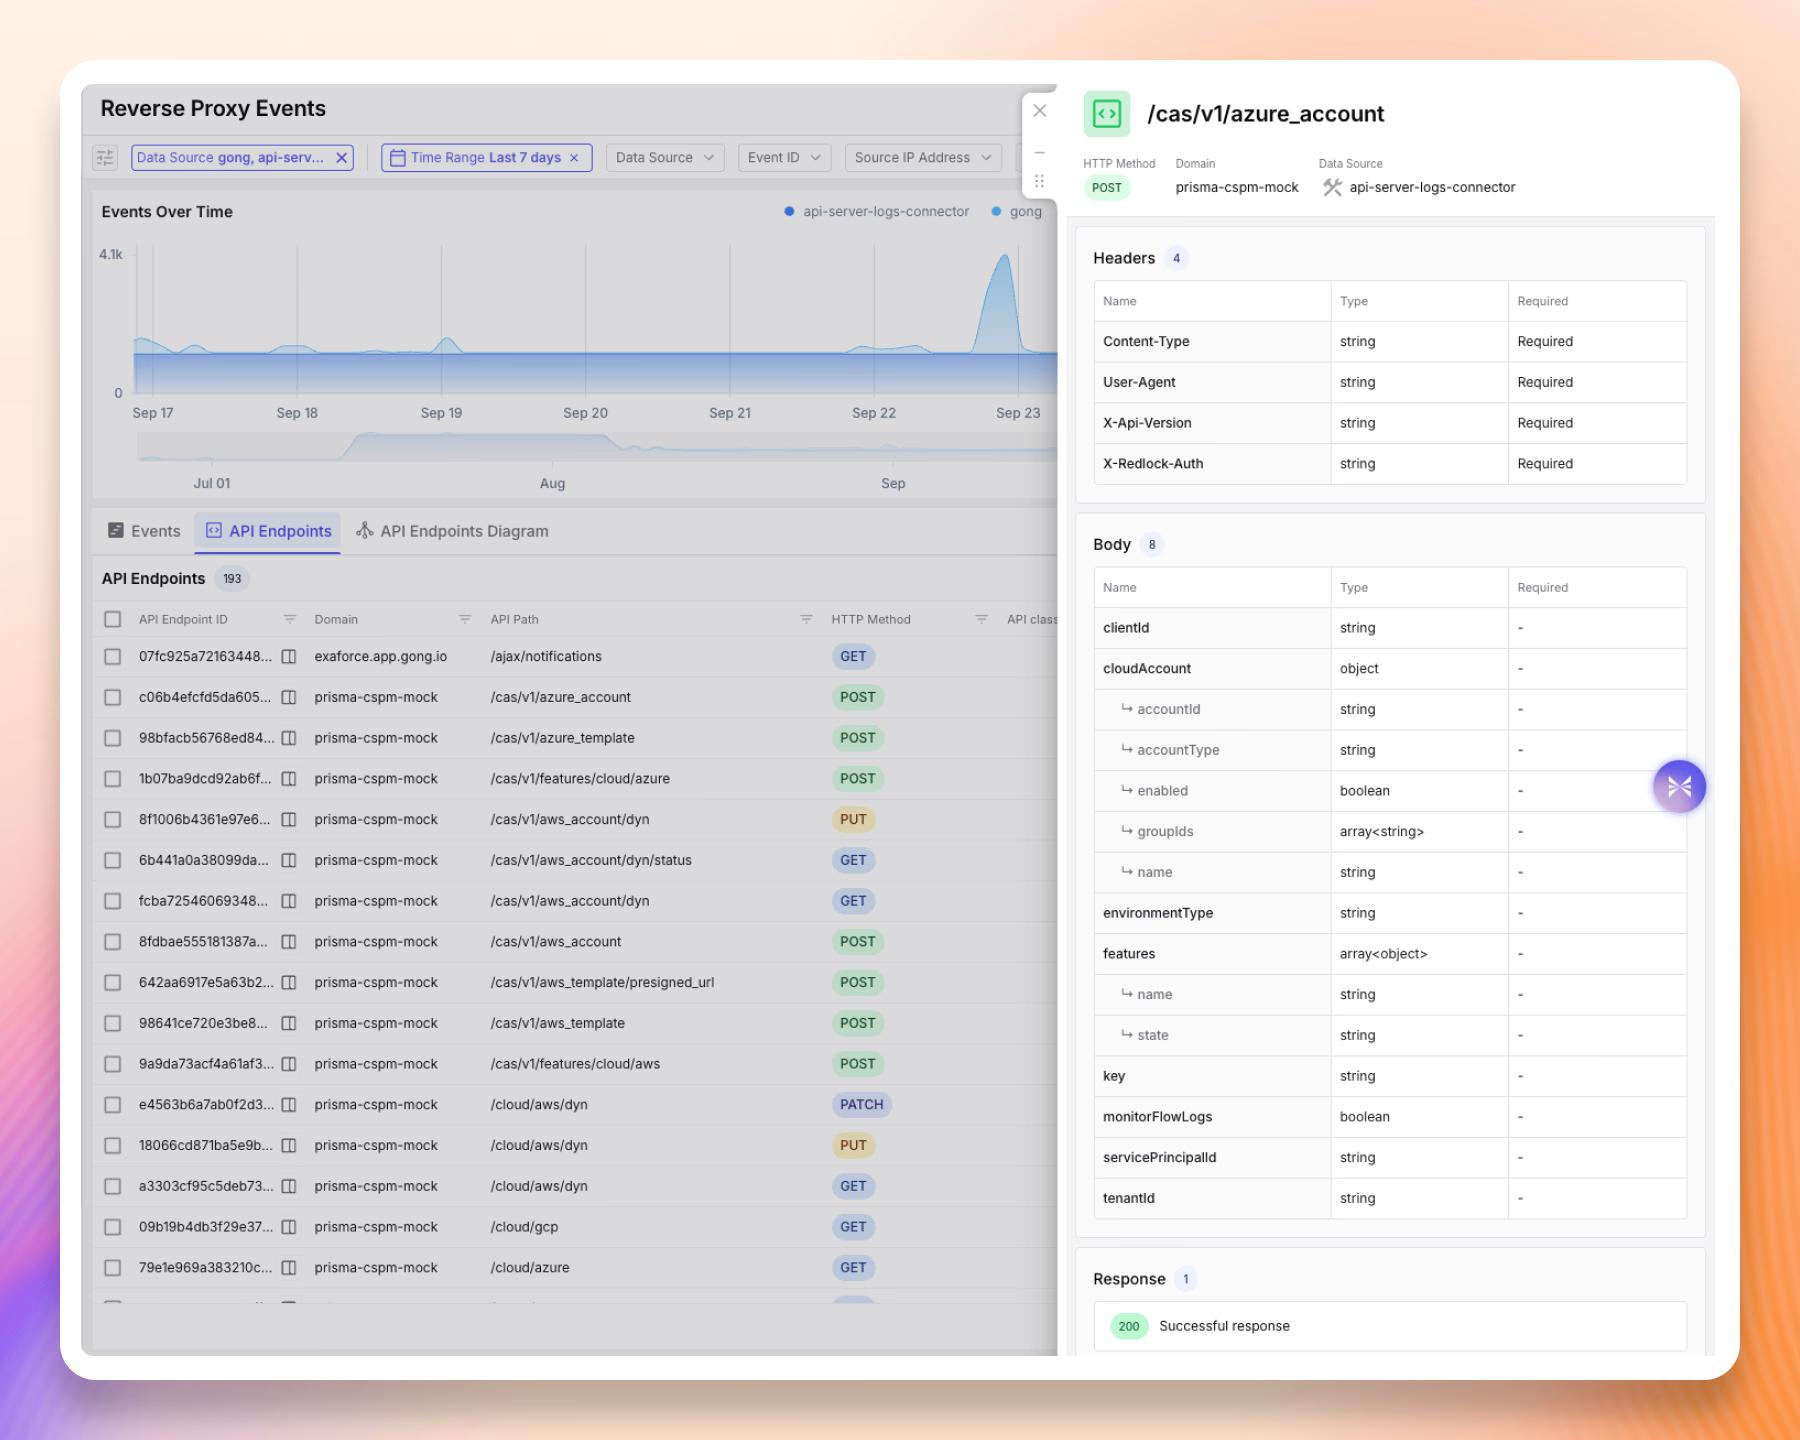
さらに踏み込みます。検出されたすべてのエンドポイントについて、システムは「通常」がどのようなものかを学習します。どのクエリパラメーターが想定されるか、その型は何か、どのヘッダーが標準か、リクエストボディはどのような形か(プロキシやAPIサーバーがそれを記録している場合)、そしてどのレスポンスコードが一般的かです。
その結果として、エンドポイントごとにAPIコントラクトが自動生成されます。学習されたコントラクトから外れるリクエストは、未知のパラメーター名、想定される型に一致しない値、見慣れないヘッダーとして検出されます。これにより、生のログインデックスでは表面化しないAPI層のアクティビティがSOCから見えるようになります。そのエンドポイントが一度も見たことのないパラメーターや値の型、想定外のヘッダーでエンドポイントを探るスキャンツール、そしてエンドポイントごとのベースラインと照らして初めて浮かび上がるAPIの不正利用パターンです。
アナリストがAPIの実装を理解する必要はありません。システムがコントラクトを学習し、そこからの逸脱を提示します。
1つのエンドポイントについて学習されたコントラクト。想定されるヘッダー(Content-Type、User-Agent、X-Api-Version)、ボディの各フィールドとその型および必須かどうか、そして想定されるレスポンス。
EDRテレメトリ:エンドポイントで何が起きているか
EDRのテレメトリは監査ログとは似ていません。どのイベントも、監査ログでは捉えられない「どのように」を伴っています。
エクサフォースは、EDRベンダーやLinux auditdのようなOSのロギング機構から届くテレメトリを、プロセスを中心としたモデルに正規化します。
デバイス上のアイデンティティがプロセス(親チェーンを含む)を実行し、そのプロセスがリソースに対してアクションを実行する
すべてのイベントは、そのプロセスのコンテキストに紐づいています。名前、パス、コマンドラインに加えて、ソースが提供している場合はSHA-256ハッシュ、発行元、署名状態、そしてそのプロセスを生成した親プロセスチェーンです。親チェーンがあるおかげで、powershell.exeがwinword.exeから起動され、そのwinword.exeはoutlook.exeから起動されていた、という教科書どおりのマクロ経由の攻撃チェーンが見えます。
イベントは構造化されたカテゴリー(プロセス、ネットワーク、ファイル、レジストリ、モジュール、認証、ログオン、検出)に分類され、型付きのアクション(作成、起動、削除、権限昇格、読み取り、終了)が付きます。リソースにも型があります。ファイル、ディレクトリ、実行ファイル、スクリプト、レジストリキー、DNSドメイン、URL、ネットワークエンドポイント、ブラウザー拡張機能、さらにはMCPサーバーやIDEプラグインといったAIエージェントのツールまで含みます。型付けがあるからこそ、検出は拡張子やインタープリターを列挙せずにスクリプト実行を狙えますし、「どのデバイスがMCPサーバーを実行したか、そして誰のアイデンティティのもとでか」がハンティングではなくフィルターになります。
デバイスのコンテキストも豊富です。デバイス種別(ラップトップ、サーバー、コンテナー、Kubernetesノード、VM)、プラットフォーム(Windows、Linux、macOS、iOS、Android)、OSバージョン、シリアル番号、クラウドプロバイダー、ハードウェアモデルまで揃います。各デバイスはそれを使うユーザーに対応づけられ、そのユーザーは全社的なアイデンティティに解決されます。侵害されたデバイスが不審なプロセスを実行したとき、見えるのはデバイスだけではありません。その人物、所属部門、上司、そしてその人がアクセスできる他のシステムまで見えます。
ベンダー独自の検出結果(CrowdStrikeのディテクション、Defenderのアラート、SentinelOneの脅威)は、MITRE ATT&CKのタクティクスとテクニックのマッピング、深刻度スコア、検出ソースのメタデータとともに取り込まれ、それを生み出したプロセスチェーンとデバイスコンテキストに関連付けられます。
プロキシログ:ネットワークから何が出ていくか
Zscaler、Cato Networks、Netskopeなどのフォワードプロキシのログは、アウトバウンドのWebアクセスを完全なセキュリティコンテキストとともに記録します。
デバイス上のユーザーがプロキシ経由でURLにアクセスし、セキュリティポリシーのアクションが適用される
このモデルは、アウトバウンドのWebトラフィックに対してプロキシが下したセキュリティ上の判断を捉えます。DLPの検出結果、URLの分類、アプリケーションのリスクスコア、マルウェアのカテゴリー、WAFの判断、帯域ポリシーの適用は、すべて正規化されたイベントの一部です。送信元と宛先の両方のIPに、完全なジオIPエンリッチメントと脅威レピュテーションのスコアリングが適用されます。トラフィックがどこへ向かったかだけでなく、その宛先が既知の脅威かどうかまで分かります。
ファイアウォールログ:境界を越えていくものは何か
Palo Alto NetworksやCatoのネットワークファイアウォールとIPSのログは、L4のフローデータに加えて、ファイアウォールが各セッションに付与するアプリケーションと脅威のコンテキストを記録します。
送信元IP:ポートがプロトコルを使って宛先IP:ポートに接続し、ファイアウォールルールのアクションが適用され、IPSが脅威を検出する
このモデルはネットワークの全体像を追跡します。NAT変換については変換前と変換後のアドレスにそれぞれ個別のジオIPエンリッチメントを行い、アプリケーションの識別、セッションの量的指標(送受信バイト数、パケット数、継続時間)、脅威分類を伴うIPSの検出までを扱います。システムは、ファイアウォールのブロックを、その背後にあるアイデンティティと、そのアイデンティティが到達しようとしていた宛先に関連付けます。
エンリッチメント層:後付けではなく、組み込まれたコンテキスト
すべてのセマンティックモデルにおいて、イベントはパイプラインを流れる過程で自動的にエンリッチメントされます。エンリッチメントは独立したSOARのプレイブックでもアナリストが起動する照会でもなく、変換処理そのものに組み込まれています。
ジオIPと脅威インテリジェンス
すべてのパブリックIPアドレス(送信元、宛先、NAT変換後)は、市区町村、国、ASN、緯度経度、位置精度に解決されます。脅威レピュテーションのフィードが、既知の悪性IP、VPNプロバイダー、Tor出口ノード、匿名プロキシを分類します。このエンリッチメントは、アナリストが調査すると決めたものだけでなく、すべてのデータ型のすべてのイベントに対して行われます。
ユーザーエージェントインテリジェンス
SaaSイベント、アクセスログ、プロキシのトラフィックを横断して、すべてのユーザーエージェント文字列が解析され、100種類を超える既知のクライアントタイプのいずれかに分類されます。次の生のユーザーエージェントを見てください。
これは不透明なテキストとして扱われません。エクサフォースはここから、クライアント=aws_cli、バージョン=2.11.20、言語=python 3.11.3、OS=macOS、アーキテクチャー=x86_64、コマンド=iam.list-roles(実行されている具体的なAWS CLIコマンド)を抽出します。
同じ深さの解析が、Terraform(プロバイダーのバージョンを含む)、AWSのSDK(boto3、Go、Java、Node、Rust、Ruby、.NET、PHP)、Kubernetesのツール(kubectl、kubelet、Argo CD)、CI/CDのクライアント(GitHub Actionsのランナー)、開発者向けツール(Postman、curl、axios)、そしてStratus Red Teamのような攻撃ツールにも適用されます。
ユーザーエージェントは、検索できるテキストから構造化されたセキュリティテレメトリになります。リクエストは「ブラウザー」から来るのではありません。macOS上のChrome 125から、あるいはPython 3.9のLinux上のboto3 1.28.17から来ます。各ユーザーが普段どのクライアントを使っているかというユーザー単位のベースラインと組み合わせれば、ツールの急な変化が検出のシグナルになります。
セッションの構築
イベントは、同一のプリンシパルによるアクティビティを時間的にまとめたクラスターであるセッションにグループ化されます。セッションは、継続時間、イベント数、機密性の高い操作が実行されたかどうか、そして人がアクティビティを主導したのかサブプリンシパルが主導したのかを保持します。セッションの構築は、個々のイベントの流れを、検出が推論できるまとまりのあるアクティビティの単位に変えます。
この基盤が可能にするもの
これらのセマンティックモデルは最終成果物ではありません。他のすべてがその上に築かれる基盤です。
共有されたセマンティックモデルがなければ、Okta、GitHub、Slackを横断してユーザーのふるまいのベースラインを作ることはできません。3つのイベントストリームが同一人物を指していることも、それぞれのイベントが比較可能な操作を表していることも分からないからです。
サブプリンシパルのラベリングがなければ、人によるインサイダー脅威と、スケジュールされたバックアップジョブを区別できません。その結果、検出は一方でノイズを出し、もう一方を見逃します。
APIエンドポイントの検出がなければ、自社のAPIにとっての「通常」が何かを知ることはできません。あるのはAPIではなくURLだからです。
ユーザーエージェントの解析がなければ、経理部門のユーザーのアカウントからのpython-requestsによる呼び出しは、検索できる文字列にとどまり、そのユーザーのベースラインと照らせるクライアントにはなりません。すべてが単なるテキストだからです。
EDR、プロキシ、ファイアウォールのイベントに共通のアイデンティティがなければ、ブロックされたアウトバウンド接続と、その背後にあるデバイスと人物は3つの別々のレコードであり、関連付けはアナリストが行うことになります。
セマンティックモデルと、そこに組み込まれたエンリッチメントが組み合わさることで、コンテキストが豊富な検出、ソースを横断した相関、そして生のログテキストではなく構造化されたコンテキストの上で推論する、根拠のあるAIが可能になります。次回は、エクサフォースがこの基盤を検出にどう活かしているかをご紹介します。アイデンティティ、リソース、ロケーション、デバイス、そしてふるまいの履歴という完全なコンテキストに照らして、すべてのシグナルを評価する仕組みです。
次回:第3回 — コンテキストが豊富な検出:分かっていることすべてを使う